安価・高速・AIプロバイダに依存しないAI基盤の構築
モデルを役割ごとに切り替えられる、実務向けAI基盤の設計と運用
皆さん、こんにちは。株式会社ヴィクセスの林高行です。
現在、弊社では複数のクラウドLLMへ役割を分けるAI基盤を運用しています。ChatGPT Proを中心に全ての業務を行っていた頃と比べて、費用は半額以下になり、処理速度も改善しました。
私は開発案件に約10年間関わり、現在は経営者として、AIの業務導入と運用設計を自ら行っています。AIは、ソフトウェア開発に加え、経理、労務、文書作成、Webサイト運用、情報整理など、日々の業務全般で利用しています。
この記事では、現在の構成へ至るまでに自社環境で比較した3つの方法と、それぞれを採用、または不採用とした理由を紹介します。モデルの性能表だけでは分からない、実務上の費用、速度、管理方法まで含めた検証記録です。同じようにAI基盤を構築する方が、不要な遠回りを避けるための材料になればと思います。
発端:AIを使いすぎて利用上限に達する
私は、ほぼ全ての業務にAIを使っていました。当時はChatGPT Proを契約し、業務ではOpenAIのCodexを利用していました。
大きな仕事では、例えば次のようなものです。
- 企業公式サイトの開発、更新、本番公開
- オウンドメディアの記事作成、編集、公開
- GitHub、Netlify、Cloud Runを使った公開環境の運用
- 顧客向けシステムの企画、要件整理、開発
- 提案書、見積書、契約書、請求書の作成
- 給与計算、源泉所得税、請求書、領収書などの管理
- Google Workspaceや社内業務システムの運用
- AIエージェントによる業務分担と並列処理
日常的な仕事では、次のような作業も任せていました。
- ミーティング候補日時の提示と予定登録
- 受信メールの確認と分類
- 議事録の作成と対応事項の抽出
- スプレッドシートの集計と整形
- Google Drive内の検索、分類、移動、名称変更
- PDF、画像、文書からの文字抽出
- Webサイトの文言修正と公開確認
- メール添付ファイルの保存と移動
仕事中は3、4個のスレッドが常に動き、夜間には約10個の自動処理を走らせていました。
当然ながら、利用量は多くなります。Codexには一定期間ごとの利用上限があり、私の場合は7日分の上限を2日ほどで使い切るようになりました。上限が更新されるまで待つか、追加料金を払う必要があります。
開発より事務利用の方が多いにもかかわらず、AIを使えない時間が生じる。これでは業務の基盤として使い続けられません。
検証1:ローカルLLMを導入する
クラウド側の利用上限が問題なら、自分のマシンで推論すればよい。最初はそう考えました。
ローカルLLMなら、クラウドサービスの利用上限を受けにくくなります。ただし、AIモデルを自分のマシンで動かすには、十分なメモリと処理性能が必要です。
そこで、全てをローカルLLMへ移すのではなく、クラウドLLMと併用する構成を考えました。
- 難しい仕事は、高性能なクラウドLLMが担当する
- ローカルLLMの作業管理と結果確認も、クラウドLLMが担当する
- ファイルの読み込み、検索、移動などの単純な仕事は、ローカルLLMが担当する
複数の担当へ仕事を分け、管理役が全体を動かす仕組みを、オーケストレーションと呼びます。実作業を行う担当はWorker(ワーカー)、全体を管理する担当はOrchestrator(オーケストレーター)です。
私はOpenCodexを使い、Mac miniへローカルLLMの実行環境とオーケストレーションの仕組みを導入しました。
「1+1」の回答に5分かかった
最初の導入には3日ほどかかりました。動作確認として、クラウドLLM経由でローカルLLMへ、次の質問を投げました。
1+1は?
返事が来るまで、約5分かかりました。
3日かけて、コンビニで売っている電卓より遅いものを作ってしまったわけです。
原因は、試したモデルに対してマシンの性能が足りなかったことでした。使用したMac miniのユニファイドメモリは24GBです。
AIモデルには、能力の低下をなるべく抑えながらデータ量を小さくする「量子化」という技術があります。量子化方式とモデルを変えれば動くのではないかと考え、4種類を順番に入れて試しました。
| モデル | 量子化方式 | 規模 | ファイル容量 |
|---|---|---|---|
| Qwen3.5 9B | Q4_K_M | 9.7B | 約6.6GB |
| Qwen3.6 27B | Q4_K_M | 27.8B | 約17GB |
| Muse-Glimmer 30B | UD-Q4_K_XL | 30B | 約15.9GB |
| Qwen3.8 27B | UD-IQ4_XS | 27B | 約14.3GB |
しかし、私の環境では、どのモデルでも回答まで約5分かかりました。1回の導入と確認に3日ほど使ったため、4種類の検証には合計で約12日を使いました。
今回の検証では、24GBのMac miniを、小型で常時稼働できる軽作業用Workerとして位置づけました。ファイルの読み込みや検索などをローカル側へ移し、クラウドLLMの利用量をどこまで抑えられるかを確認しました。
専用のGPUサーバーや大容量メモリを備えたマシンを用意すれば、処理速度の改善が見込めます。一方で、機器への投資に加え、電力、保守、モデル更新、障害対応などの運用も必要になります。今回重視したのは、モデル性能の上限を追うことより、費用を抑えながら短期間で実務に使えるAI基盤を構築することでした。
4種類のモデルを試した結果、この環境では軽作業用Workerとしても必要な応答速度に届きませんでした。ここから専用機への投資を進めるより、複数のクラウドLLMを使い分ける方が、導入速度、費用、保守負担の面で今回の目的に合うと判断しました。
ローカルLLMは、機密情報を外部へ出せない場合や、十分な設備と運用体制を用意できる場合に有力な選択肢です。今回の構成では、ローカル環境への追加投資を行わず、クラウド上で担当モデルを切り替えられる方式を採用しました。
検証2:GPT系のモデルだけで分担する
ローカルLLMを全業務へ使う案を見送り、次はGPT系のクラウドモデルだけでオーケストレーションを組みました。
- Orchestrator:GPT-5.6 Sol
- Worker:GPT-5.6 Luna
仕事の難しさに応じて、Worker側の思考の強さをlow、medium、high、maxから、Orchestratorの判断で、自動的に切り替えられるようにしました。
この構成にも3日ほどかかりました。完成後に実際の業務で動かすと、利用量は大きく減りました。Solだけを使い続けるより、安価なLunaへ実作業を分けたためです。
費用を抑えるという目的は達成しました。一方で、処理速度が次の課題になりました。
ローカルLLMよりは速かったものの、複数の仕事を平常運用するには待ち時間が長すぎました。費用だけを見て安いモデルへ寄せると、今度は速度が業務を止めます。
削減できる費用より、待ち時間による業務への影響が大きいと判断し、この構成も採用を見送りました。
検証3:安くて速い複数のクラウドLLMを組み合わせる
ここまでの2つの検証で、必要な条件が明確になりました。費用を抑えるだけでは足りず、実務で待たされない速度と、特定の会社やモデルに依存しない構成が必要です。
- ローカルLLMだけでは、私のマシンで必要な速度が出ない
- GPT系のモデルだけでは、費用は下がっても全体が遅い
そこで、会社や系列を一つに絞らず、安くて速いクラウドLLMを仕事ごとに使い分けることにしました。
現在は、中国企業を含む多くの開発元が、モデルの重みを公開するオープンウェイトモデルを提供しています。Ollama Cloudを使うと、自分のマシンへ載せきれないモデルもクラウド上で利用できます。
この構成では、モデルとアプリケーションを分けて選びます。複数の提供元を一つの画面から呼び出せるアプリケーションなら、仕事の管理方法を維持したまま、担当モデルだけを入れ替えられます。
そこで使ったのが、Hermes Agentです。
Hermes Agentには、依頼をチャットの中で抱え続けず、仕事としてカンバンへ登録するカンバン機能があります。チャットは、相談し、依頼する場所です。実作業はカンバンで進み、誰が担当しているのか、どこまで進んだのか、確認を待っているのかを管理できます。
仕事ではなく、役割にモデルを割り当てる
Hermes Agentでは、assignee(アサイニー)、つまり担当者と言う概念があり、各仕事へ割り当てることができます。担当者ごとに、使うモデルと役割をあらかじめ決めておきます。
私の環境では、主に次の役割を使っています。
- Decomposer(デコンポーザー):依頼を実行可能なタスクへ分ける
- Orchestrator(オーケストレーター):全体を管理し、タスクの担当と順序を決める
- Worker(ワーカー):調査、整理、ファイル操作などの実作業を行う
- Reviewer(レビュワー):Workerとは別のモデルで結果を確認する
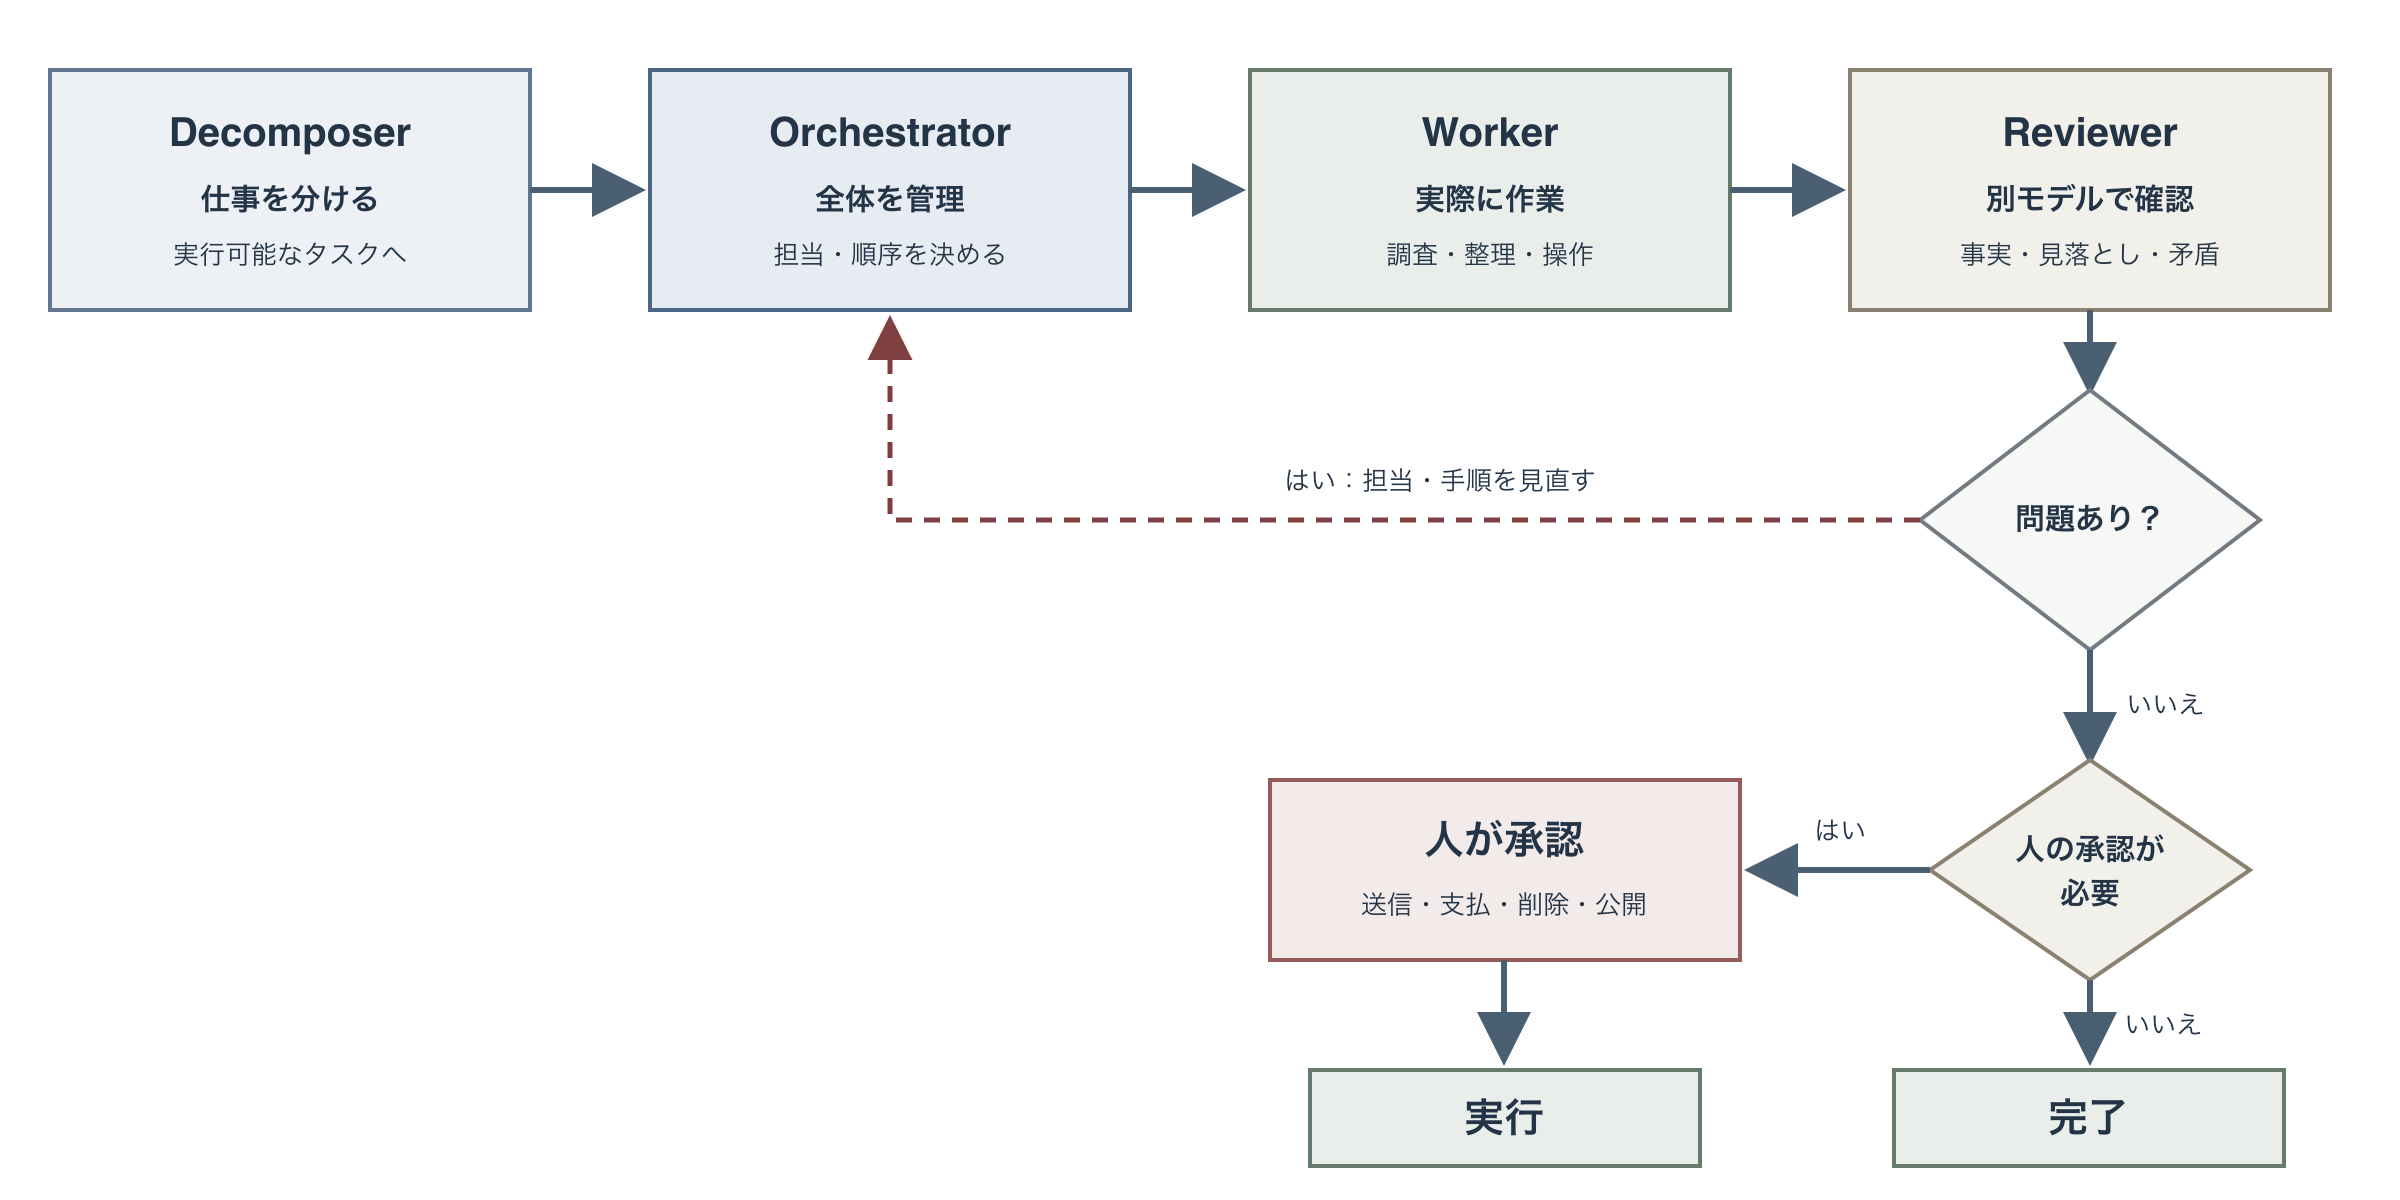
大切なのは、全ての仕事を最も高性能なモデルへ任せないことです。
難しい判断や全体管理には能力の高いモデルを使い、範囲が明確な作業には安くて速いモデルを使います。結果は別モデルが確認し、送信、支払い、削除、公開などの重要な操作は人が承認します。
現在の役割分担
2026年8月29日時点では、次の構成で運用しています。
| 役割 | 主な用途 | 使用モデル | 提供元 | 思考の強さ |
|---|---|---|---|---|
| Decomposer | タスクの自動分解 | glm-5.3-flash | Ollama Cloud | 専用指定なし |
| Orchestrator | 分解後の整理、担当振り分け | grok-4.6 | xAI | medium |
| Orchestrator・予備1 | Orchestratorの予備 | glm-5.3-flash | Ollama Cloud | high |
| Orchestrator・予備2 | Orchestratorの予備 | glm-5.3-flash | Ollama Cloud | high |
| 通常Worker | ローカルファイル、Web検索、一般作業 | deepseek-v4-flash | Ollama Cloud | low |
| 上位Worker | 高度な判断、難しい作業 | glm-5.3-flash | Ollama Cloud | high |
| Chrome Worker | Browser UseによるWeb操作 | glm-5.3-flash | Ollama Cloud | high |
| Computer Use Worker・急ぎ | GUI操作、緊急性が高い作業 | gpt-5.6-terra | OpenAI | 指定なし |
| Computer Use Worker・非緊急 | GUI操作、急がない作業 | gpt-5.6-luna | OpenAI | 指定なし |
| Computer Use Worker・予備 | GUI操作の予備 | deepseek-v4-flash | Ollama Cloud | low |
| Reviewer | 独立した確認 | glm-5.3-flash | Ollama Cloud | max |
ここで示したモデルは、2026年8月29日時点で各役割に割り当てているものです。提供元の混雑、障害、料金改定、モデル更新によって速度や品質が変わるため、状況に応じて担当モデルを入れ替えます。また、オープンウェイトモデルの開発も速く、1週間後には別のモデルを使っているかもしれません。
ちなみに、Hermes Agentでは、用途や設定を分けたAIの担当者単位を「プロフィール」と呼びます。各プロフィールには、役割、使用するモデル、思考の強さ、利用できる機能などを設定できます。
各社のモデルは異様なほど速いペースで進化しており、現在使っているモデルも、短期間で頻繁に切り替わることを想定しておく必要があります。そのため、プロフィール名にはモデル名を使わず、WorkerやReviewerなどの役割名を付けています。担当モデルを変更しても、仕事の流れやプロフィール名を変えずに運用できます。
構築する際に、先に決めておくこと
3つの構成を実際の業務で比較した結果、モデル選びより前に決めておいた方がよいことが分かりました。
1. 実際の仕事で速度を測る
短い質問への回答速度だけでは、実務で使えるか判断できません。長い文書の読み込み、Web検索、ファイル操作、複数タスクの同時実行など、実際に任せる仕事で測る必要があります。
2. 高性能なモデルを全作業へ使わない
全てを最上位モデルへ任せると、費用と利用量が増えます。難しい判断、一般作業、Web操作、GUI操作、確認を分け、それぞれに必要な能力を持つモデルを割り当てます。
3. 実行と確認を別のモデルへ分ける
一つのモデルが行った作業を、同じモデルだけで確認すると、同じ見落としを繰り返すことがあります。重要な仕事は、別のモデルをReviewerとして使います。
4. 人が承認する操作を決める
AIが作業できることと、自動で実行してよいことは別です。送信、支払い、削除、公開、権限変更などは、人が確認する場所を残します。
5. いつでも担当モデルを替えられるようにする
モデルの性能低下、障害、料金変更は避けられません。特定モデルの名前を業務手順へ埋め込まず、役割ごとに差し替えられる構成にしておくと、変更時の影響を小さくできます。
費用は半額以下になり、速度も上がった
現在の構成では、ChatGPT Proだけで全ての業務を行っていた頃と比べて、費用は半額以下になりました。処理速度も大きく改善しています。
もう一つ良かったのは、モデルごとの得意、不得意を理解できるようになったことです。
仕事ごとに必要な性能は異なります。範囲が明確な作業では、安価なモデルの方が速く正確に進むこともあります。反対に、価格だけで選ぶと、待ち時間や確認のやり直しで業務全体が遅くなります。
費用、速度、回答の質は、仕事全体がどれだけ早く、安全に完了するかという視点で評価する必要があります。
今回の検証では、特定モデルの知識に加え、AIへ任せる範囲を決める判断基準も得られました。どの仕事をAIへ任せるのか、どの情報を外部へ出せるのか、必要な速度はどの程度か、結果を誰が確認するのか。この順序で考えることで、実際の業務に合った構成を選べます。
顧客のAI基盤も、実際の業務を小さな単位へ分けるところから設計します。機密性、難易度、費用、速度に応じて担当を決め、実行結果は別のモデルや人が確認します。障害や品質低下が起きた場合には、担当モデルを切り替えます。
自社環境で採用と不採用の両方を経験したことで、推奨する構成の理由と、別案を選ぶ条件まで説明できるようになりました。これが、今回の検証で得た最も大きな成果です。
AI・LLM領域で、上位0.1%のプロフェッショナルとしてご一緒頂ける方へ
こうしたAI基盤を顧客の業務や既存システムに合わせて設計、実装するには、モデルの知識だけでなく、業務理解、システム設計、運用、関係者との調整まで横断して考えられる人材が必要です。
Excellent Partnersでは、AI・LLM案件を含む重要プロジェクトで、設計、実装、開発、プロジェクト管理を担って頂けるプロフェッショナル人材を募集しています。
ご一緒したいのは、東京大学、東京科学大学、東北大学、東京理科大学などの理工系修士・博士人材、10年程度の開発経験を持つシニアエンジニア、開発PM、日英バイリンガルPM、アルゴリズム・データサイエンス人材などです。ただし、学歴や技術力だけで判断することはありません。
私たちが重視しているのは、既存チームの中で協働できること、主体的に動けること、課題を自ら見つけて提案できること、相手に合わせた円熟したコミュニケーションができることです。指示された作業をこなすだけでなく、案件を前へ進めるところまで担って頂ける方を探しています。
AI・LLMの設計や実装、AIを業務へ組み込む基盤づくり、複数のモデルやAIエージェントを使った運用に関心をお持ちの方は、Excellent Partnersへお声掛け頂けましたら幸いです。